一个 AI 方向学生的自述:从一句"我脑子里有个模糊的想法",到一个 47 个测试全绿、能出 SCI 投稿级图表的完整系统。这篇是这个项目从孕育到出生、再到被反复"打脸"和修复的完整记录。
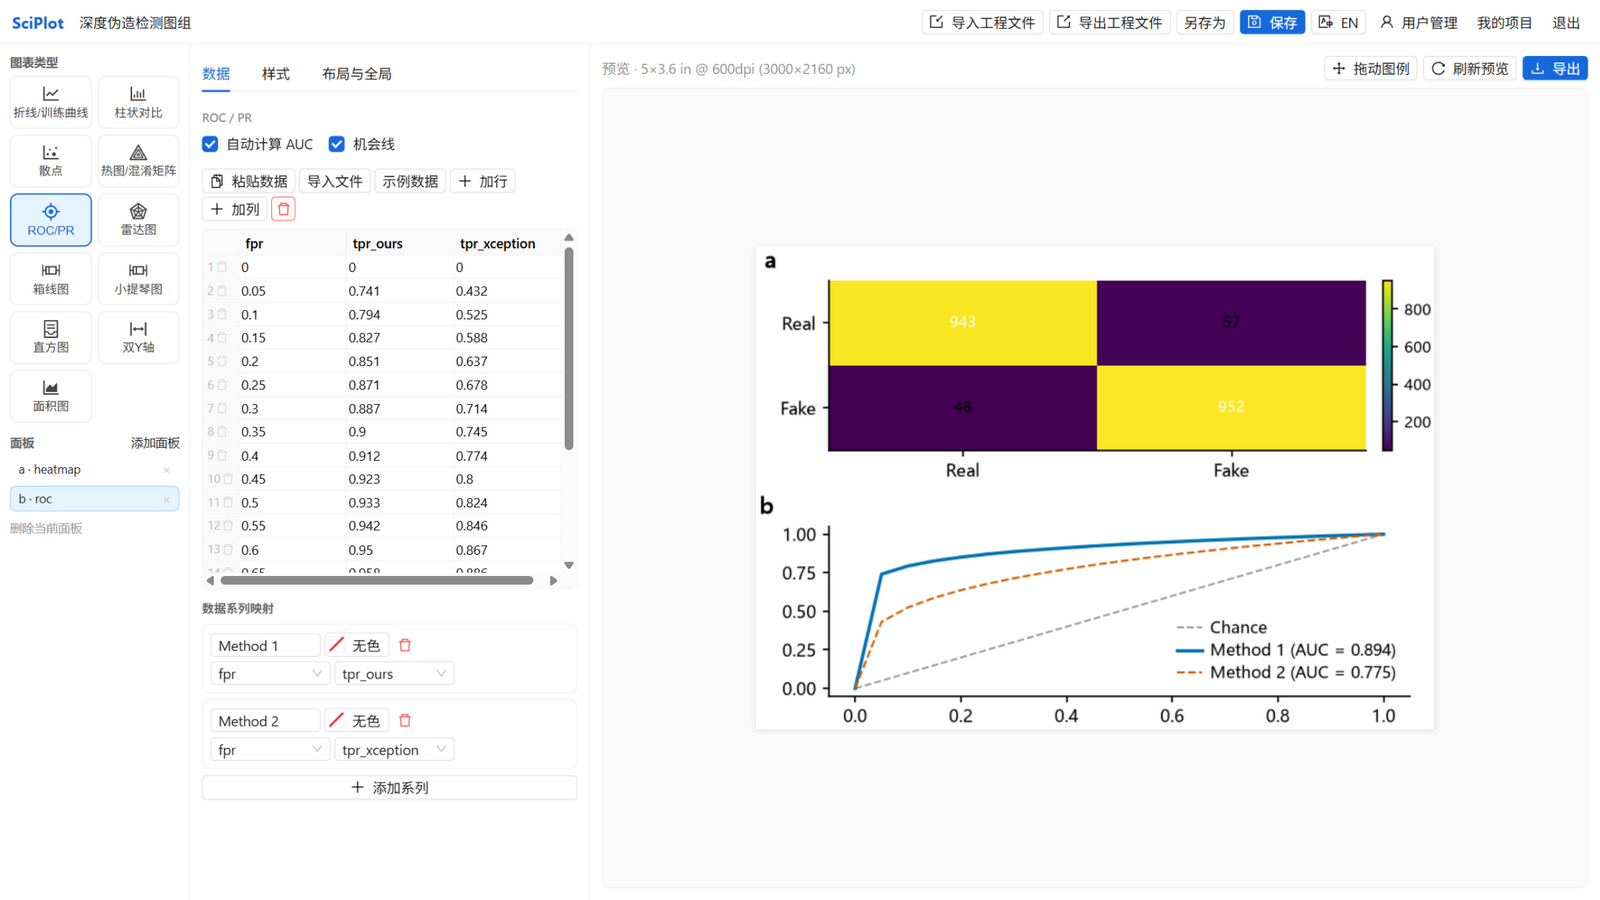
一、缘起:每个课题组都有一段画图的血泪史
我们组是做深度伪造识别的。做 AI 的人都知道,一篇论文里,模型再好,图画砸了,审稿人的第一印象就砸了。
我们的画图日常是这样的:师弟 A 用 Origin,鼠标点了两百下,导出的图源文件丢了改不动;师姐 B 用 matplotlib,每个人手里都有十几份长得差不多但谁也复用不了的绘图脚本;轮到我,最怕的是组会前师妹拿着一张轴标签是日文的图问我"师兄这个怎么改"。
更本质的矛盾是:会画图的人不做图,做图的人不写代码。matplotlib 严格、精确、可复现,但它有一个代码门槛;Origin 直观,但它黑盒、贵、且和论文对不上参数。
所以我脑子里有了一个模糊的想法:做一个工具,把 matplotlib 的严谨装进一个人人会用的界面里。
二、一个"固执"的需求
这个项目一开始不是写代码,而是被"采访"。
我让 AI 先别动手,先问我问题。两轮问下来,需求画像逐渐清晰:SCI 投稿为主、训练曲线和混淆矩阵是刚需、要多面板拼图、要支持多种子误差带。但真正定下整个项目灵魂的,是采访里我补充的一句话:
图表一定要规范,必须用后端的标准代码来渲染,而不是前端画着玩。要严谨。
现在回头看,这句话是整个项目最正确的决定。它意味着:前端只负责编辑和交互,所有图表由服务器端的 matplotlib 一行行代码画出来——你在预览里看到的,就是你导出拿到的,一个像素都不会变。所见即所得,在科研作图这件事上不是体验加分项,而是严谨性的底线。
于是架构被这句话钉死了:
前端(React 编辑器) → 一份 JSON 配置(ChartSpec)
                          ↓
后端(FastAPI + matplotlib)→ 渲染 → 预览 / 导出 600DPI
这份 ChartSpec 就是全部:数据、样式、布局、模板,一张图的一切。前端编辑它,后端渲染它,项目保存它,同学之间分享它。
三、第一张图出现的那天
项目文件夹是空的。git init,写文档,然后从最难的部分干起:渲染引擎。
定义好 ChartSpec、写完渲染管线、把十一种图表类型做成插件(折线、柱状、混淆矩阵热图、ROC、雷达、箱线、小提琴、直方图、双 Y 轴、散点、面积),然后跑了第一个测试——18 个全过。
但测试通过不等于图能看。我至今记得点开第一张多面板拼图时的感觉:不对,面板全叠在一起了。排查之后发现是网格位置计算公式写反了,row = i % rows 在 2×2 网格下让四个面板两两重叠。
那一刻我给自己立了条规矩,后来写进了项目的教训文档里:
测试断言 len(data) > N 只能证明"没报错"。渲染类代码的正确性,必须人工看图。
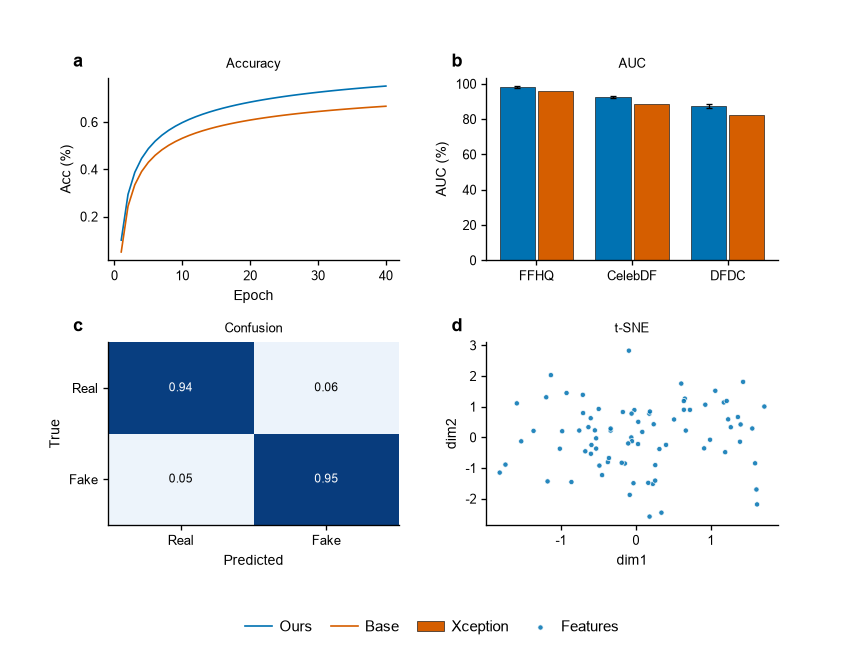
修好之后看到的第一张正经拼图,a/b/c/d 标签齐全、混淆矩阵和 ROC 混排、底部统一图例——
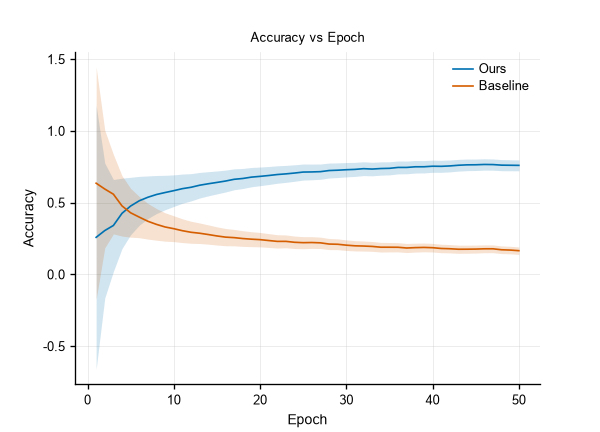
训练曲线也出来了,色盲友好的蓝橙配色,误差带半透明地垫在曲线下面:
四、界面长出来的过程
渲染核心稳了之后,前端工作台开工。React + Ant Design,三栏布局:左边选图表类型,中间填数据和调样式,右边实时预览。
中间踩了一个让我印象极深的坑。预览区无论如何都不渲染——没有请求、没有报错,就是一片空白。我盯着代码看了很久,最后发现是 React StrictMode 的"特性":开发模式下 effect 会执行两次,我的防抖定时器在第一次执行后建立、被清理函数取消,第二次执行时又被"已渲染过"的标记直接跳过。于是第一次渲染永远不会发生。
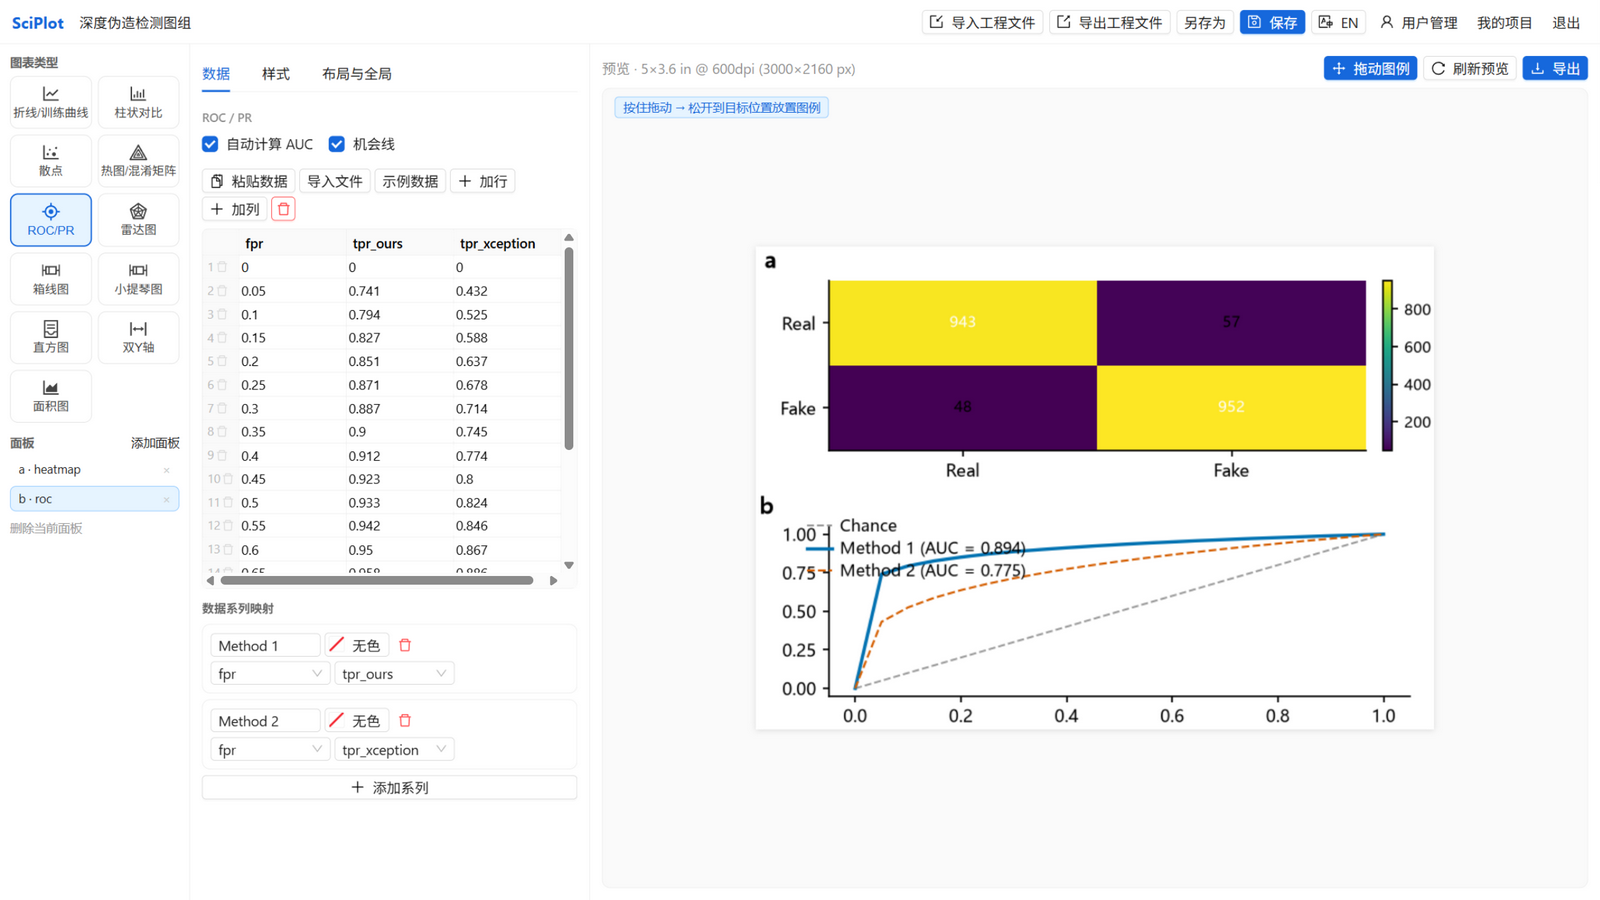
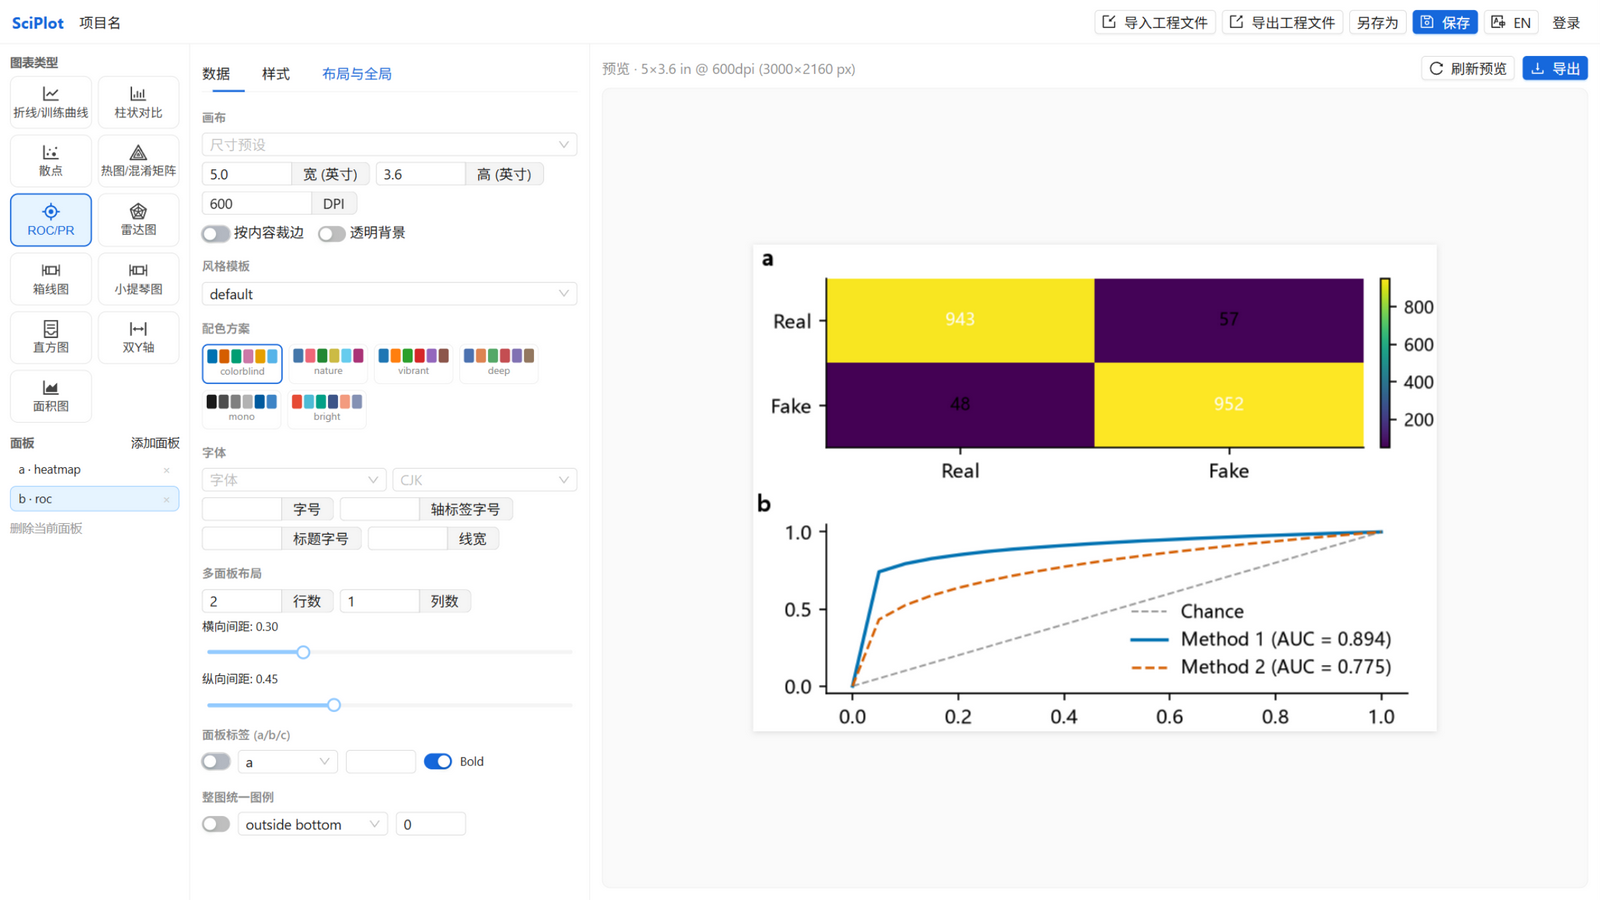
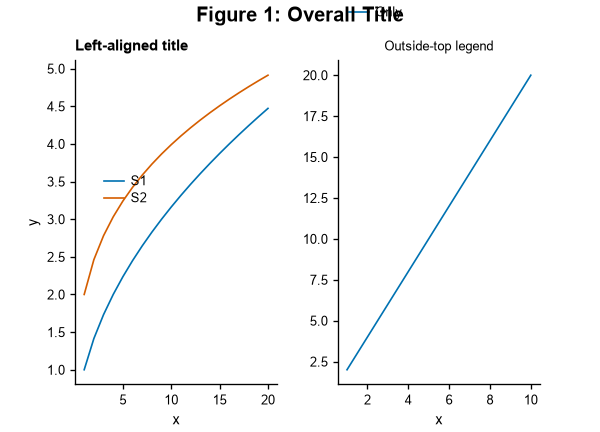
修好它之后,界面逐渐有了温度:图表类型做成卡片、点一下自动带示例数据"一键成图";粘贴 Excel 数据自动解析成表格;风格模板一键换肤;图例可以直接在预览图上拖动放置,松手就落到你想放的位置——下面这张 ROC 图的图例,就是被我从右下角拖到左上角的:
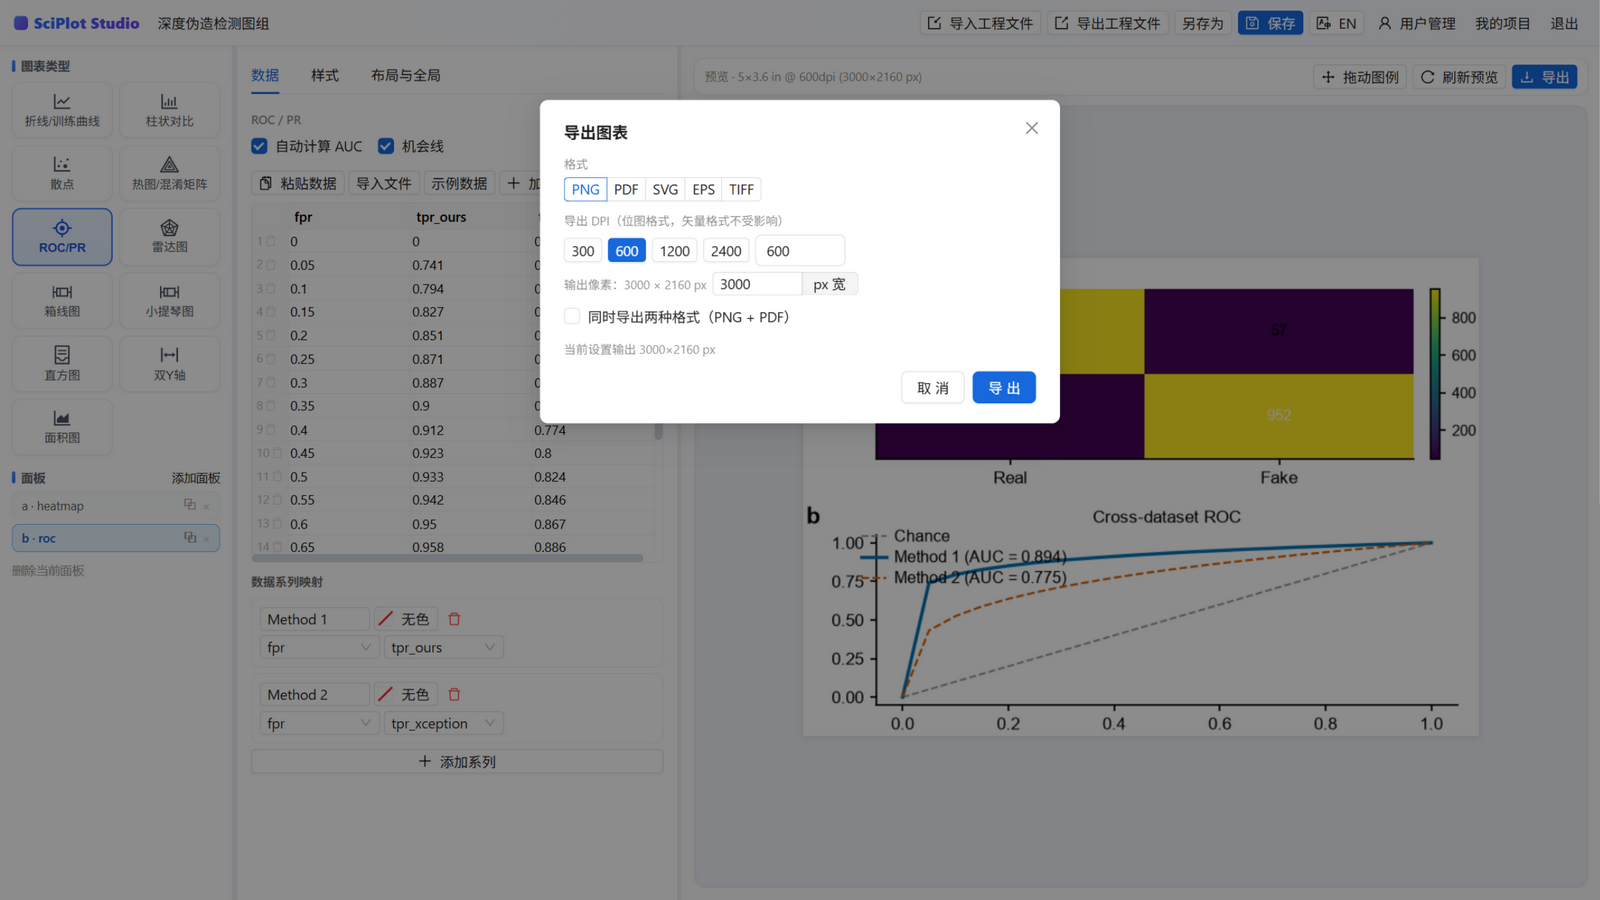
导出对话框也按投稿的真实需求做:PNG、TIFF 给位图,PDF、SVG、EPS 给矢量,DPI 一键预设 300/600/1200/2400,还能直接填目标像素宽度、勾选"同时导出 PNG+PDF"——因为期刊就是要位图和矢量各交一份。
五、被自己写的 bug 教育的日子
如果说架构是项目的骨架,那 bug 就是项目的老师。这个项目教会我的三次"打脸",我都记进了教训文档。
第一课:堆叠柱状图根本没有堆叠
全面审计那天,我怀疑堆叠柱状图有问题,写了个探针一跑——S2 系列直接把 S1 盖住了。代码里 bottoms 变量认真地累积着每一列的高度,却从来没有传给 ax.bar() 的 bottom 参数。测试一直是绿的,因为测试只断言了"渲染不报错"。
修复前后对比,一目了然:
| 修复前(互相覆盖) | 修复后(真正堆叠) |
|---|---|
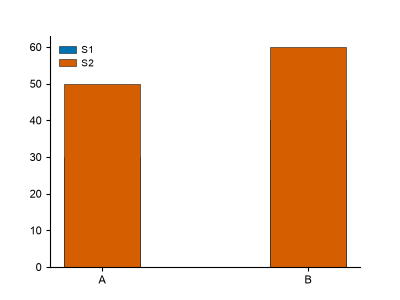 | 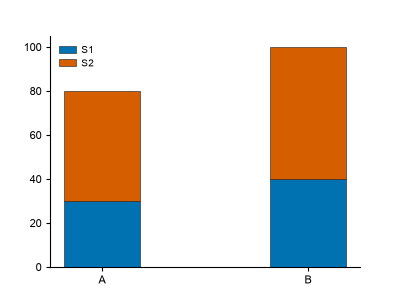 |
从那以后我加了一条规则:凡是"状态累积"的绘图分支,必须有插件级单测直接断言基线数值。
第二课:幽灵系列
更可怕的 bug 是"静默画错"。用户改了表头,旧配置里引用旧列名的系列找不到列了,代码怎么办?原来的回答是:回退成行号,画出一条 y = [0, 1, 2] 的假对角线,混在真数据里,毫无提示。
我写了一套"数据保真度测试":渲染完直接从 matplotlib 的图对象里把实际画出来的数值抠出来,和输入数据逐点断言。这套测试揪出了三个静默不一致——顶层 X 轴配置从未生效、幽灵系列画假数据、文本列被整列丢弃。现在这 16 项测试是整个项目我最自豪的部分:今后任何人改任何代码,只要破坏了"画出来的 == 数据",测试立刻变红。
第三课:细节才是严谨
修到深处,全是细节:中文用微软雅黑时坐标轴负号会变方框(缺 Unicode 负号字形);导出 PDF 时中文会丢字形(Type 3 字体不支持中日韩,必须强制 Type 42);密集曲线加标记会糊成一团(要按间隔取样);ROC 曲线的数据没覆盖端点时要自动锚定 (0,0) 和 (1,1) 再积分,否则 AUC 算出来就是错的——下面这张图的 AUC 标注,全部是按数据现场积分算出来的:
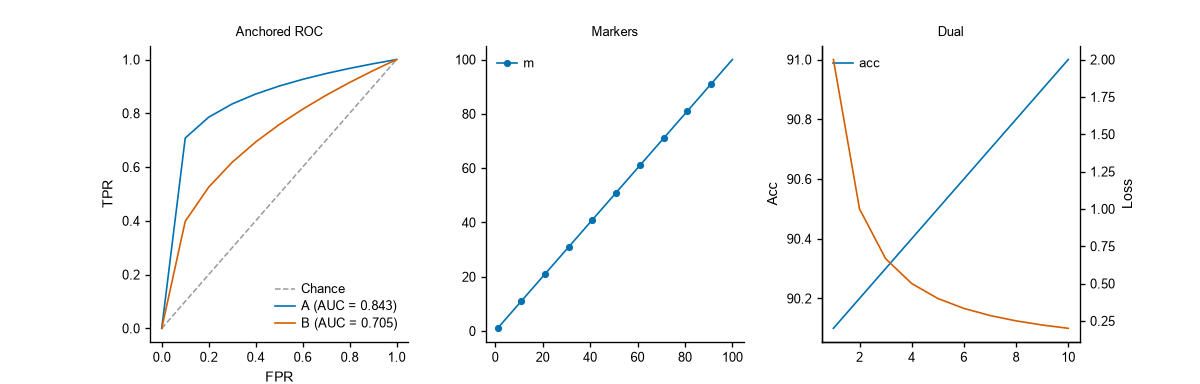
每一个细节都是实际投稿会踩的坑。
六、它现在长这样
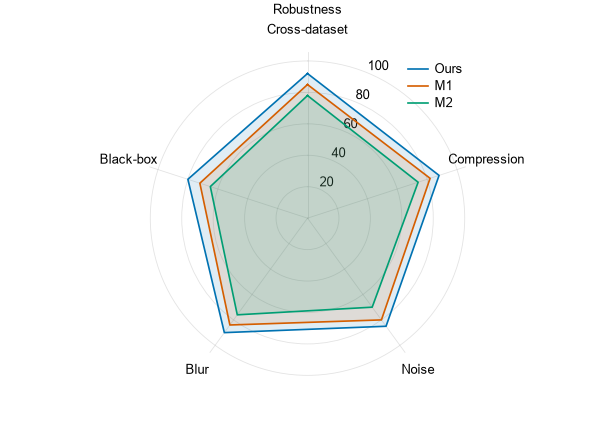
两轮全面审计、十篇教训文档、四十七个测试之后,它稳了。折线、柱状、混淆矩阵、ROC(自动算 AUC)、雷达、箱线、小提琴、直方图、双 Y 轴、散点、面积,十一种图表全部数据保真;多面板拼图、拖拽图例、期刊模板、项目云端保存、中英双语、Windows 桌面版离线包、Docker 一键部署,都在。
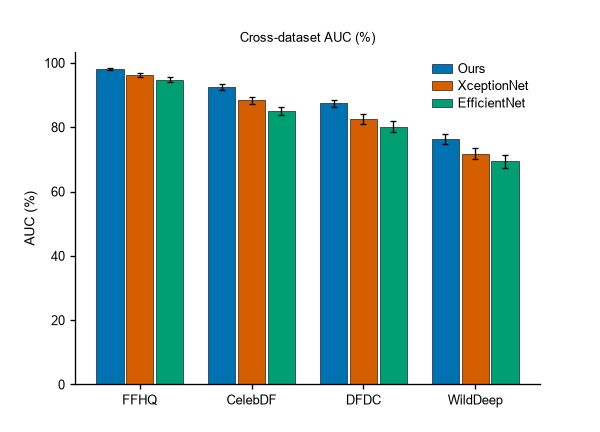
跨数据集对比的分组柱状图——误差棒、细描边、紧凑图例,这就是它现在"随手"就能出的水准:
七、一些数字
- 前后端 + 桌面版 + 部署脚本,12 次 git 提交,每次提交都是完整可运行的状态
- 47 个自动化测试全绿,其中 16 个是数据保真度测试
- 11 种图表类型,插件化注册,新增一种不用动架构
- 10 篇踩坑教训文档——它们和代码一样重要
八、写在最后
这个项目最有趣的转变是:一开始我想的是"做个工具给课题组用",做着做着变成了"用工程化的方法重新认识科研绘图"。
科研作图的严谨,不是某个高大上的算法,而是一堆朴素到近乎偏执的规则:预览必须等于导出、画出来的必须等于数据、出错了必须大声说而不是默默画错。这些规则每一条背后都是一次真实的翻车。
接下来,它会被部署到组里的云服务器上,师弟师妹们粘贴数据就能出图;师妹再也不会拿着日文轴标签的图来找我了——大概吧。
项目的教训文档里有一句话,我把它也送给你:
犯过的错误记下来,反复出现的问题沉淀为技能。
技术栈:React 18 + TypeScript + Ant Design | FastAPI + matplotlib + SQLite | pywebview + PyInstaller | Docker Compose
文中所有图表均由 SciPlot Studio 自身渲染导出——是的,它画的第一批用户就是写它的人。
评论
抢个沙发还没有评论,来说点什么吧。