记一个业余项目的诞生:44 个大模型、每个数字都有出处、每天凌晨自己巡逻更新。
文中所有截图均为线上实拍,网站在这里:https://model.heylai.cyou
起因:我受够了"到处问"
这几年用 AI 的朋友大概都有类似的经历——
想挑个大模型,先去搜索引擎。张三说 A 家最强,李四说 B 家封神,点进官方页面,每一家都在庆祝自己遥遥领先。好不容易找到第三方评测,A 榜单说它 96 分,B 榜单测出来只有 80 分,评论区还在吵架说测的不是同一个版本。
更让人心累的是迭代速度。上个月还站在领奖台上的型号,这个月就悄悄退居二线,价格表一周三变。信息不是没有,是太碎了,而且很多是"王婆卖瓜"。
于是我萌生了一个念头:自己搭一个网站,把主流大模型的数据集中放在一处——跑分、价格、上下文长度、擅长什么、短板在哪,全部摆在一起。不吹不黑,每个数字都注明出处,点一下就能跳到原始来源;查不到的数据就老老实实写"待核实",绝不编一个数字凑数。
说干就干。
它长什么样子
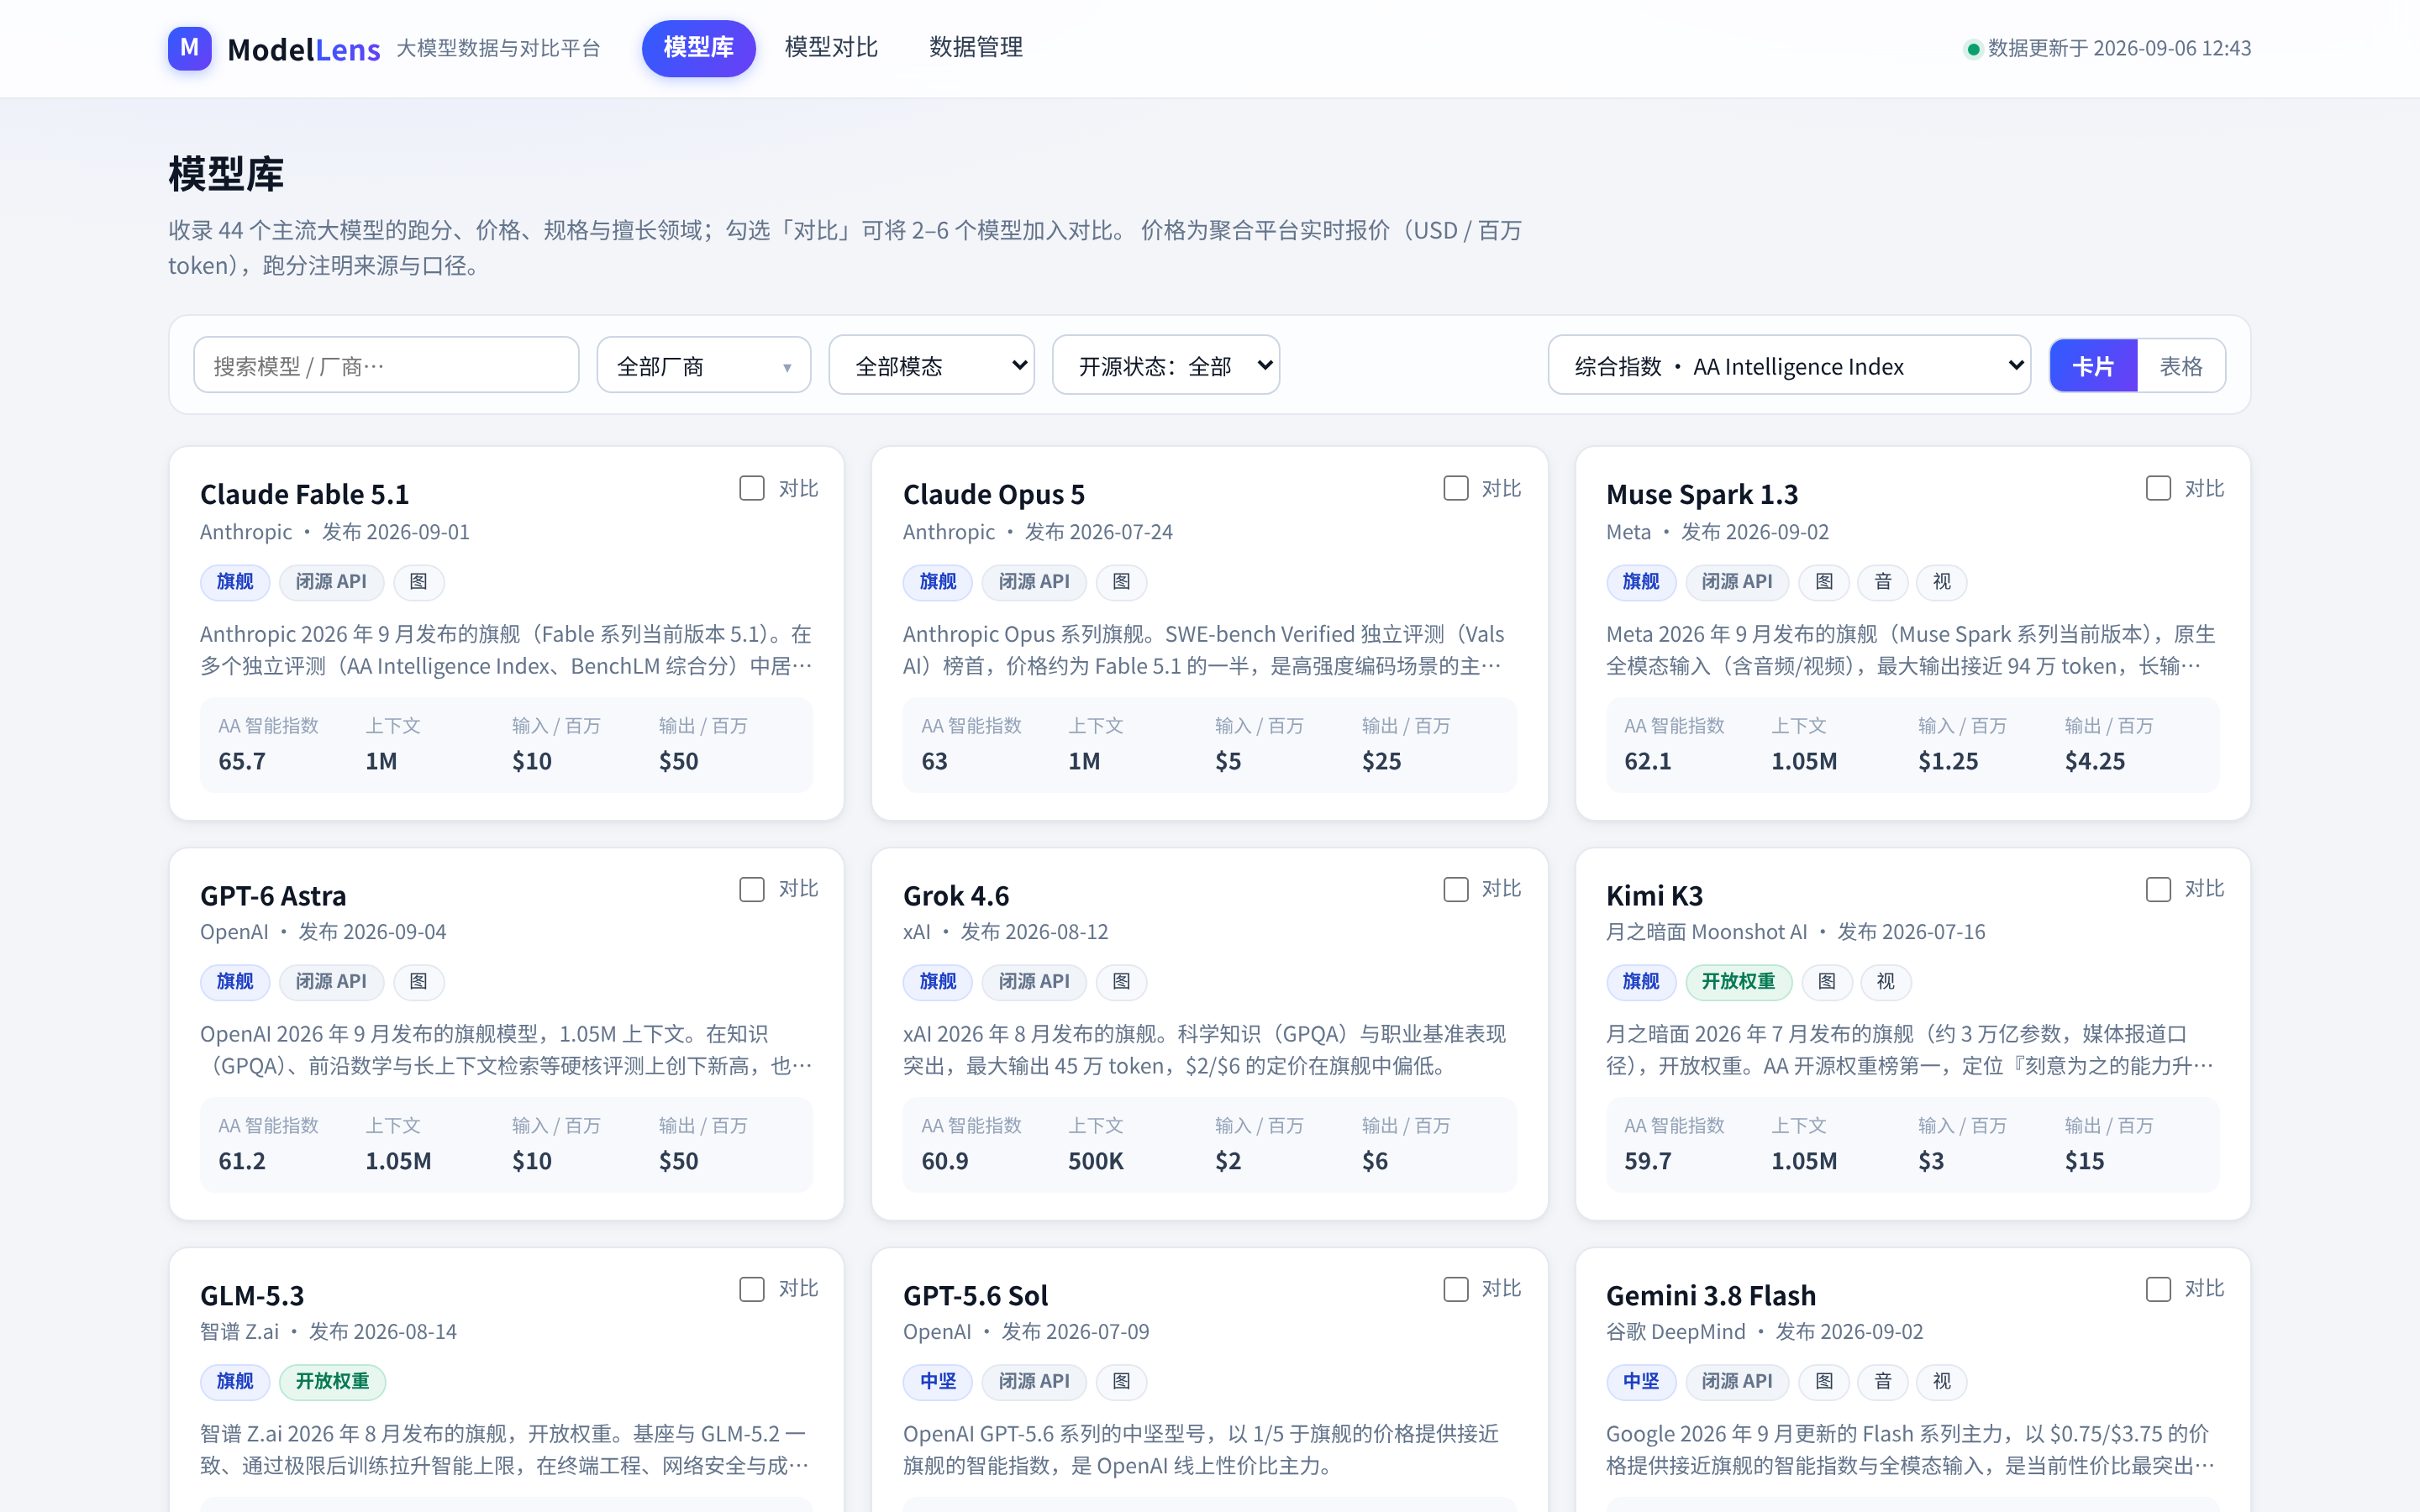
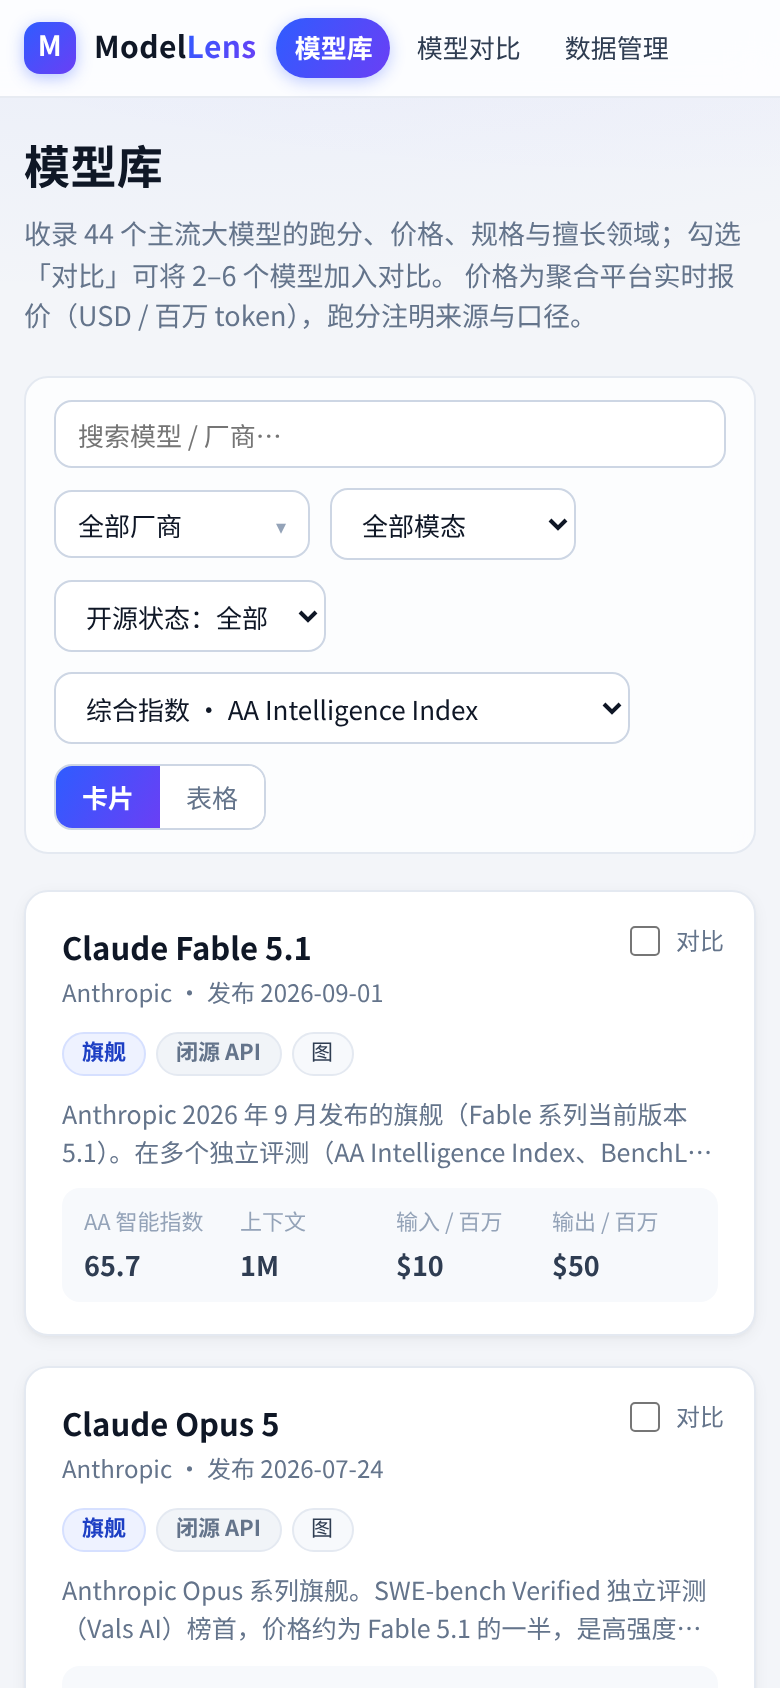
先上门面照。这是网站首页——模型库,四十四个主流模型一字排开。每张卡片上写着它的身价(每百万 token 多少钱)、脑力(独立评测的智能指数)、记性(上下文窗口)和本事(能不能看图、听音、看视频)。顶部的筛选器按国家给厂商分了组,每家后面还标着"几个模型",想同时看两家以上的厂商,勾上就行。
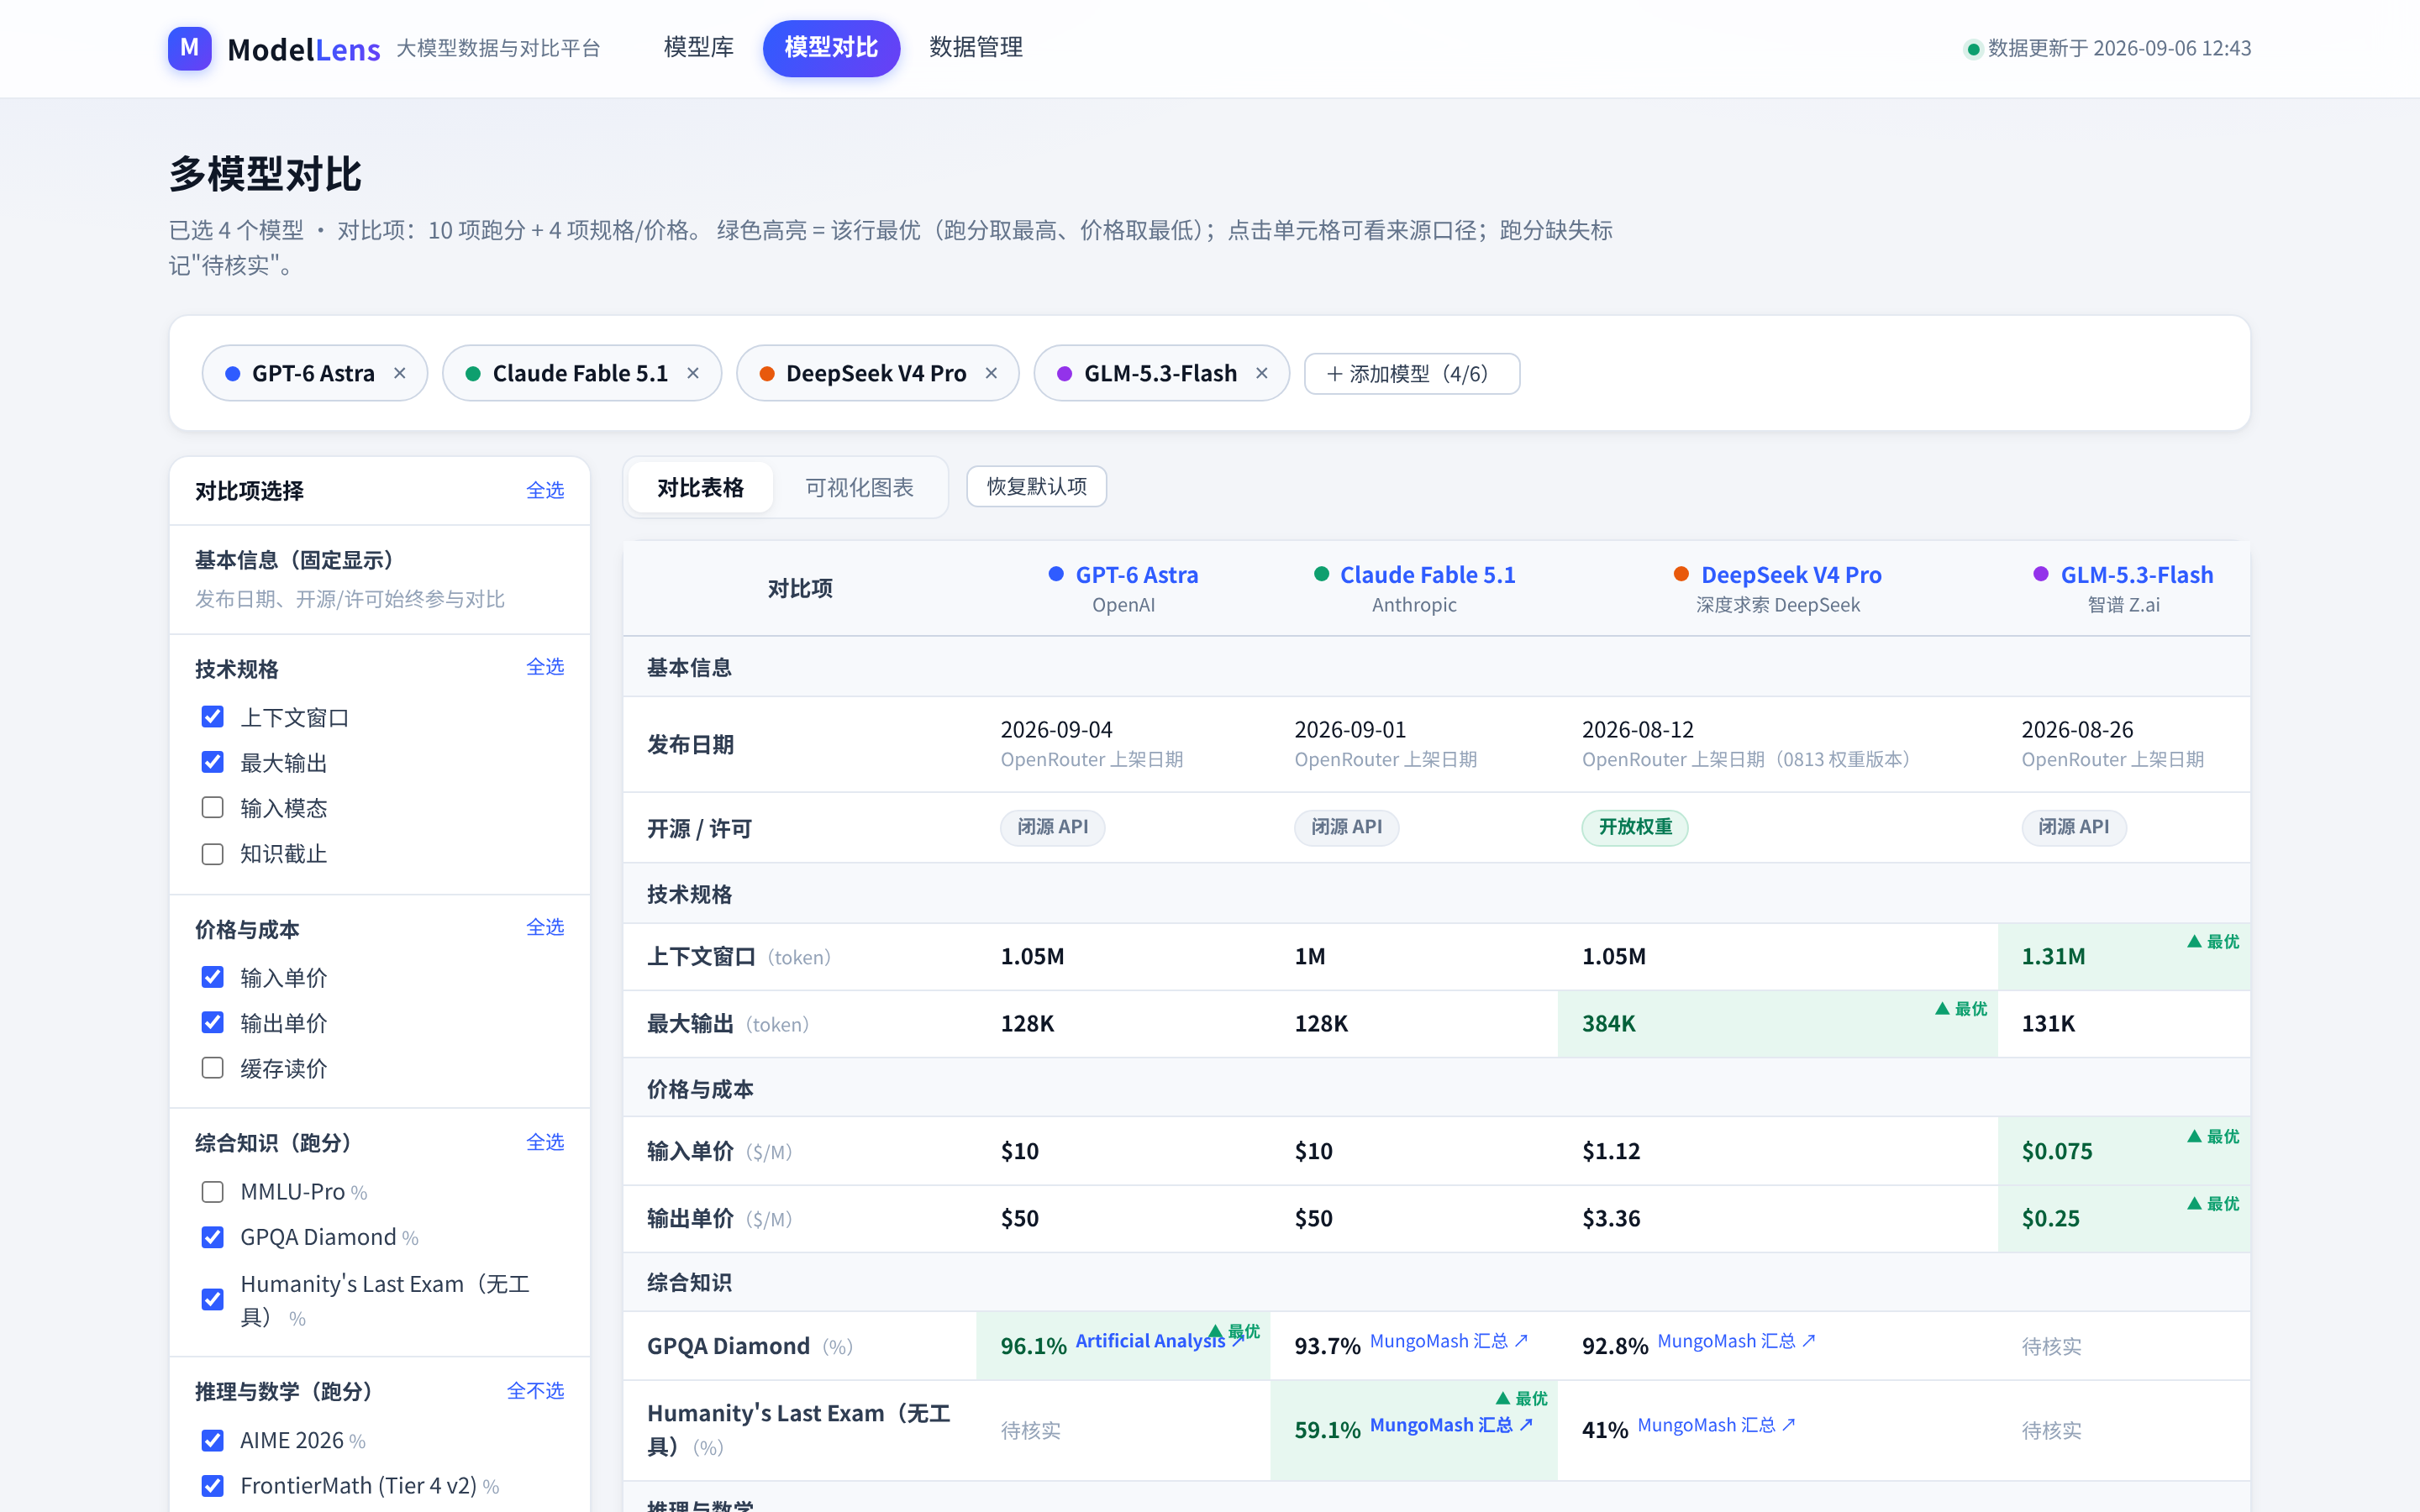
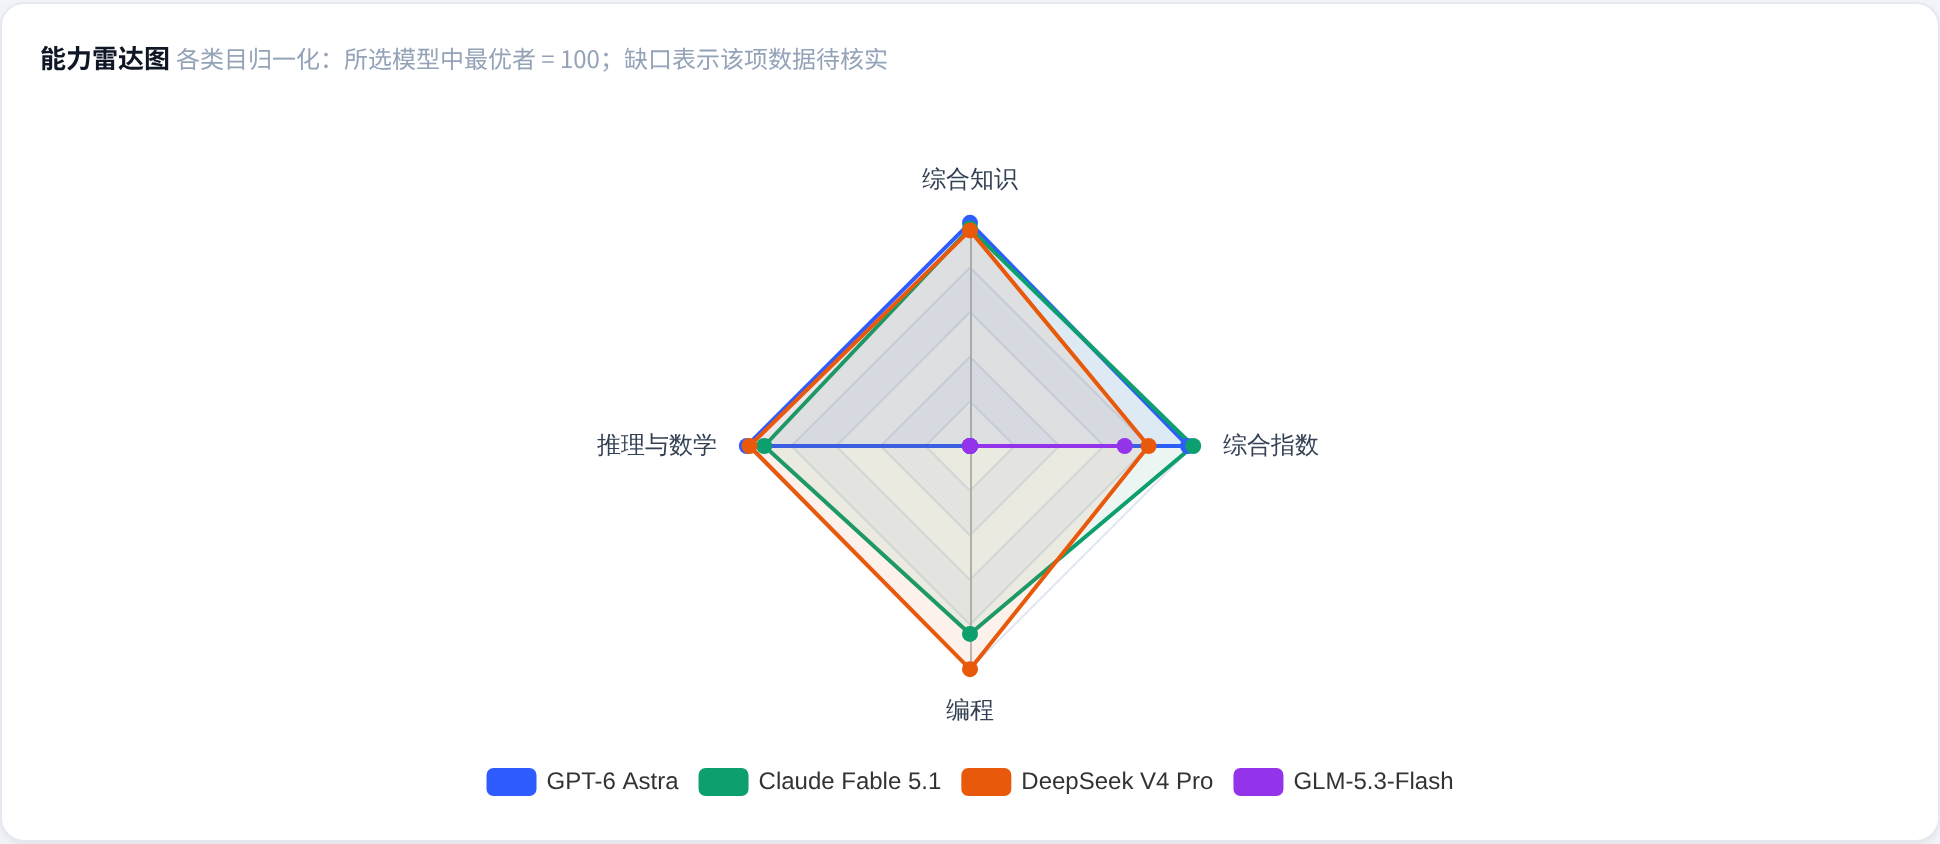
看到感兴趣的,勾选"对比",拖到底部的对比栏,就进了网站真正的主角——多模型对比。下面这张图里四位顶级选手同台竞技:知识谁最扎实、编程谁最猛、谁又便宜又能打,绿色的小"最优"标记直接圈出来。表格看腻了,一键切换成雷达图,几个模型的能力形状差异一眼分明。
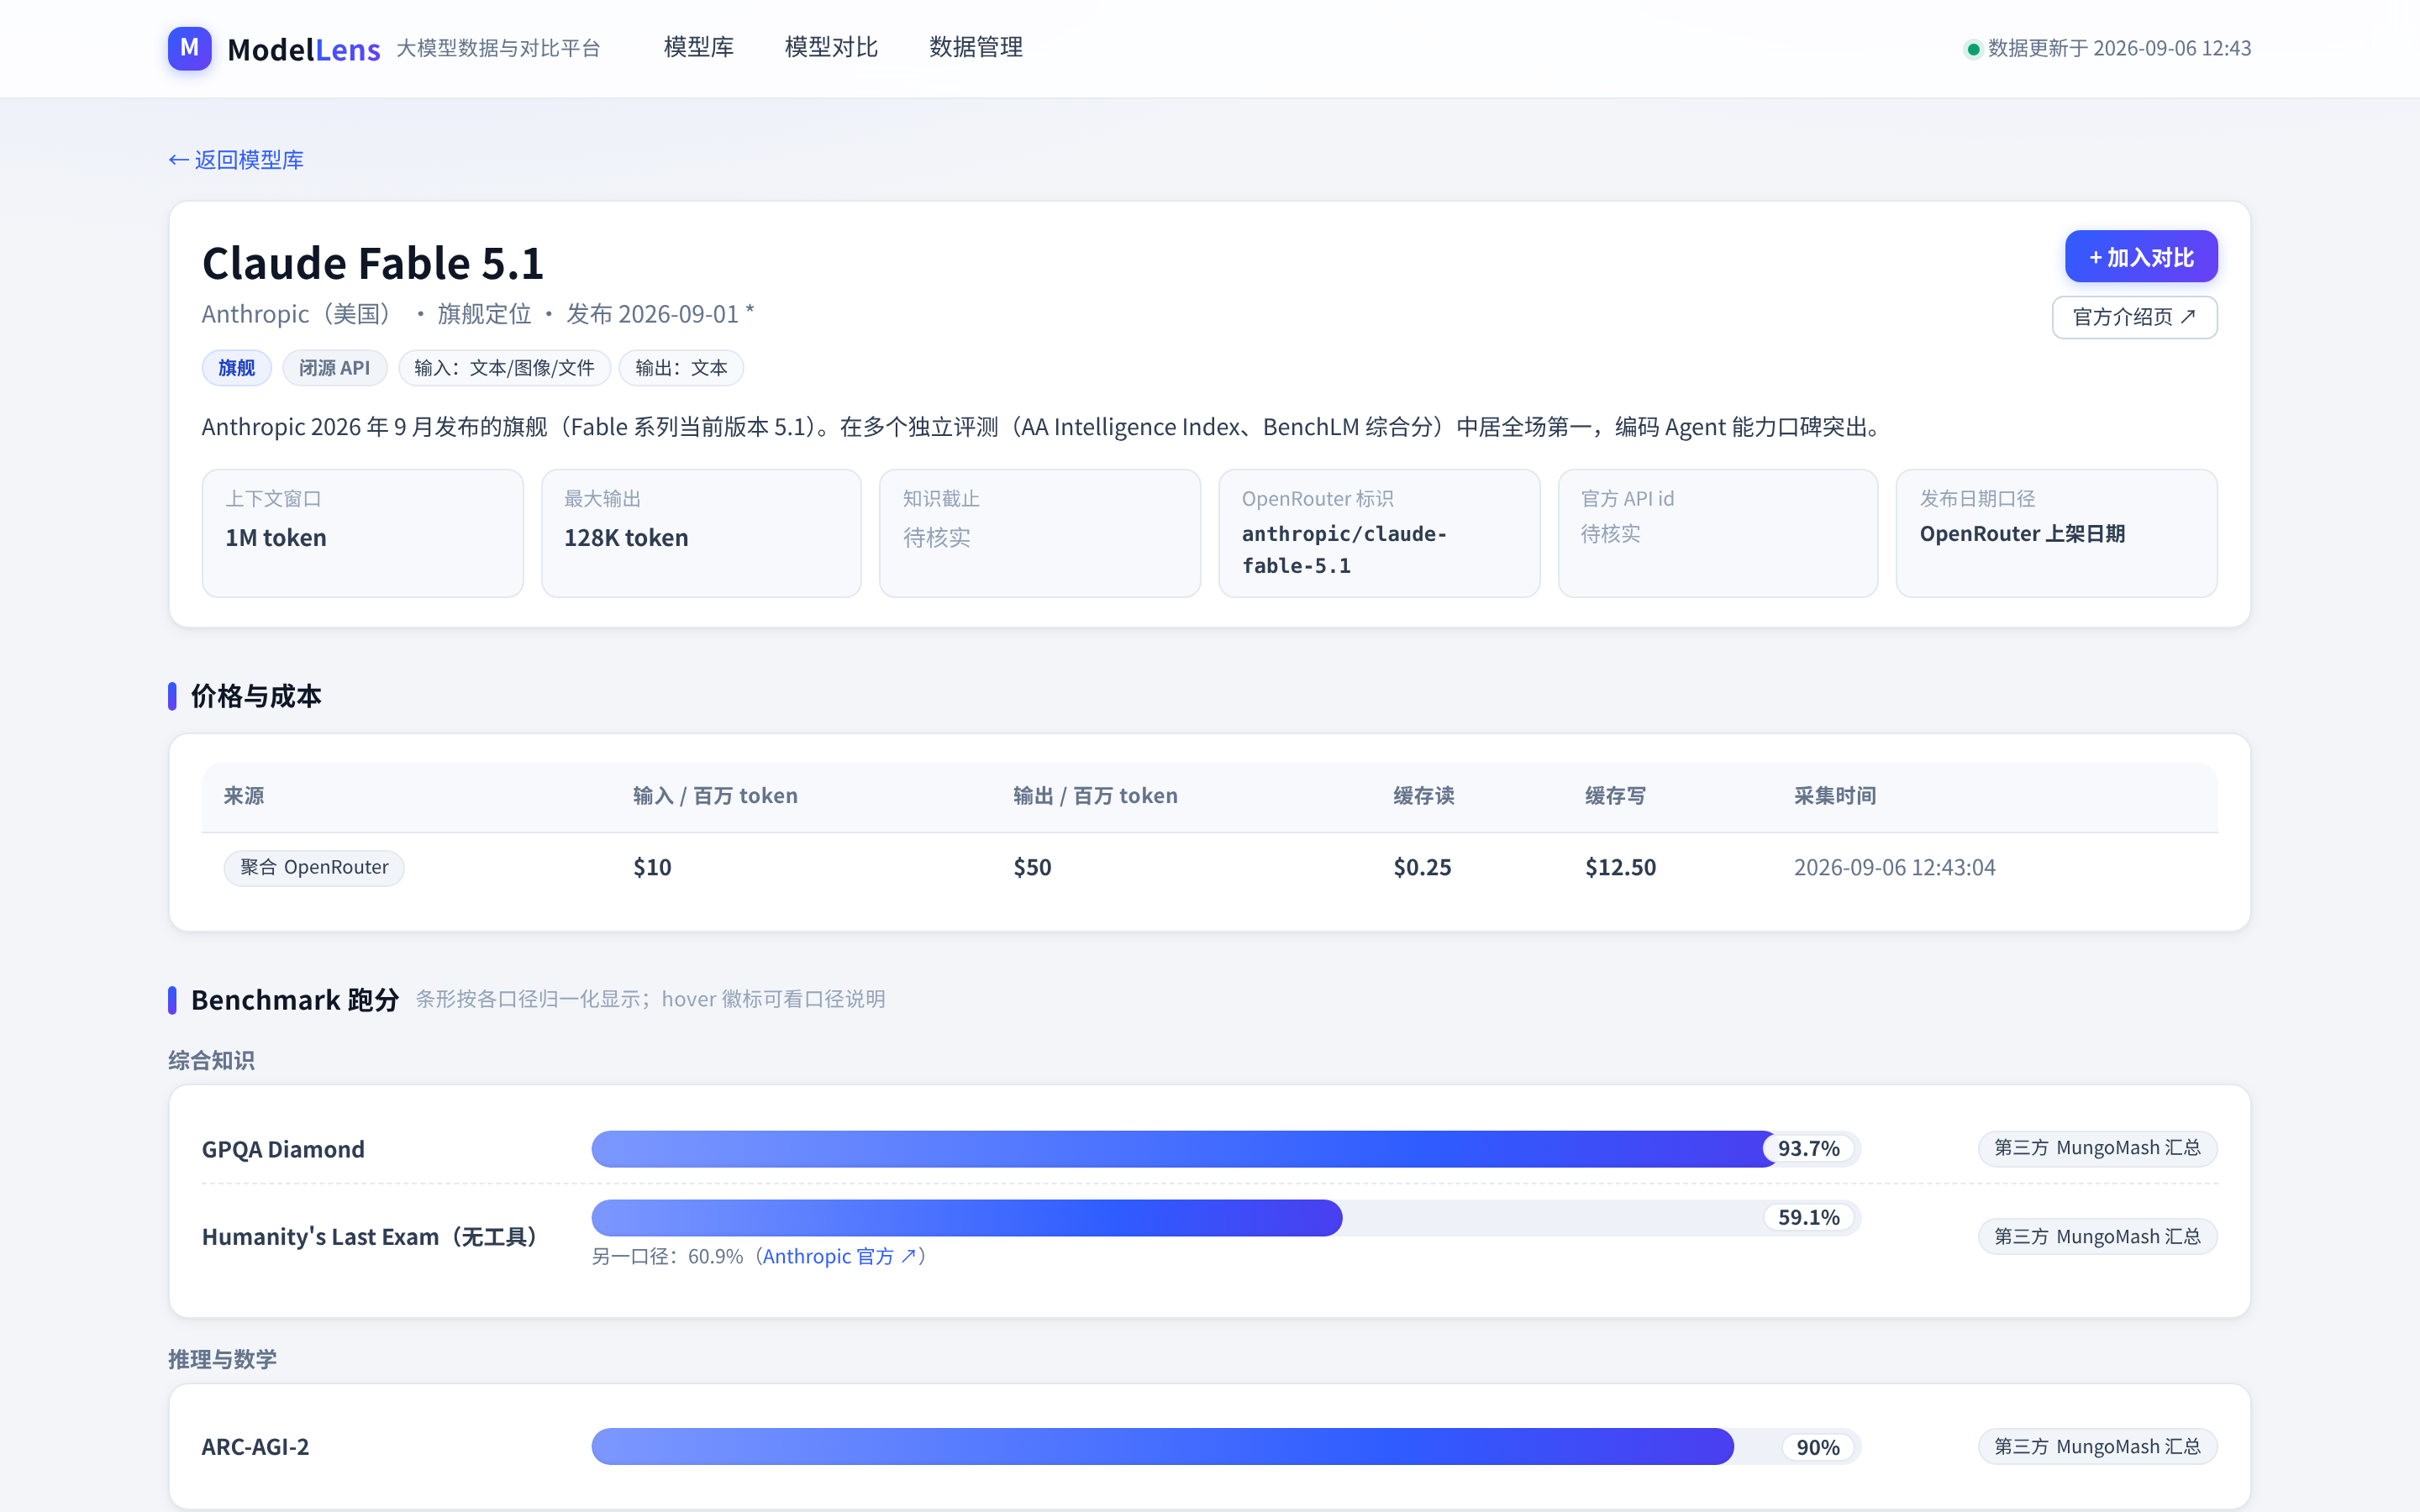
点开任何一张卡片,是它的"个人档案":官方报价、第三方实测、不同口径的分数并列展示、擅长什么、短板在哪、适合什么场景。整个网站我最得意的就是这个细节——每个数字旁边都有来源标注,点击即达。这个网站不替你下结论,它只负责把证据整整齐齐摆在你面前。
手机上也能顺畅使用,毕竟查模型这种事,经常发生在通勤路上和饭桌上。
折腾路上摔的几跤
项目做得不大,跟头摔得不少。挑几段印象深的记在这里。
第一跤:把服务器"团灭"了
部署前期排查问题,我想清理自己起的测试进程,用了一条"把所有 XX 进程都杀掉"的粗暴命令。结果呢?服务器上几个不相干的常驻服务、连同我自己赖以操作的远程连接,一起被送走了。
重新连上服务器的那一刻,后背有点凉。从那以后我给自己立了条规矩:在服务器上动手之前,先问自己一句"这刀下去会不会误伤别人"——定位到具体的那个进程、那个文件、那个端口,再出手。宁可多花两分钟,不再图那一秒钟的省事。
第二跤:绿色高亮给了"最差"的模型
网站基本成型那晚,我在对比页盯着看,总觉得哪里不对:一列跑分里,标着"最优"的绿色怎么落在一个明显偏低的数字上?
顺着查下去,是个特别隐蔽的约定没对上:数据库里记录"分数是越高越好",前端读的时候用了另一个拼法,没读到,就自作主张按"越低越好"处理了。于是所有跑分行的高亮全部标反——数字都端端正正摆在那里,只是颜色颁错了奖。这种毛病最会伪装,也正因为这样,揪出它的那一刻格外痛快。
第三跤:下拉菜单里的"无名氏"
后来我给厂商筛选做了个精致的分组菜单,发布前自己一测,傻眼了:分组标题下面是一片空白,十四家厂商的名字全都不见了。
排查了半天,发现数据其实传到了前端,只是前后端对同一个字段的名字约定没对齐——它叫 name_zh,我读的是 nameZh,一个下划线之差,名字全丢了。更绝的是,菜单打开后还被下面的卡片悄悄挡住了一层,点选择根本点不中。两个问题叠在一起,看起来就是"点了没反应"。
修好那一刻,看着"智谱 Z.ai(3 个模型)"整整齐齐列在分组里,有一种说不出的舒坦。
让它自己长大
网站上线只是开始,我不想当一个人肉运维。
于是给它装了三个"自动装置":
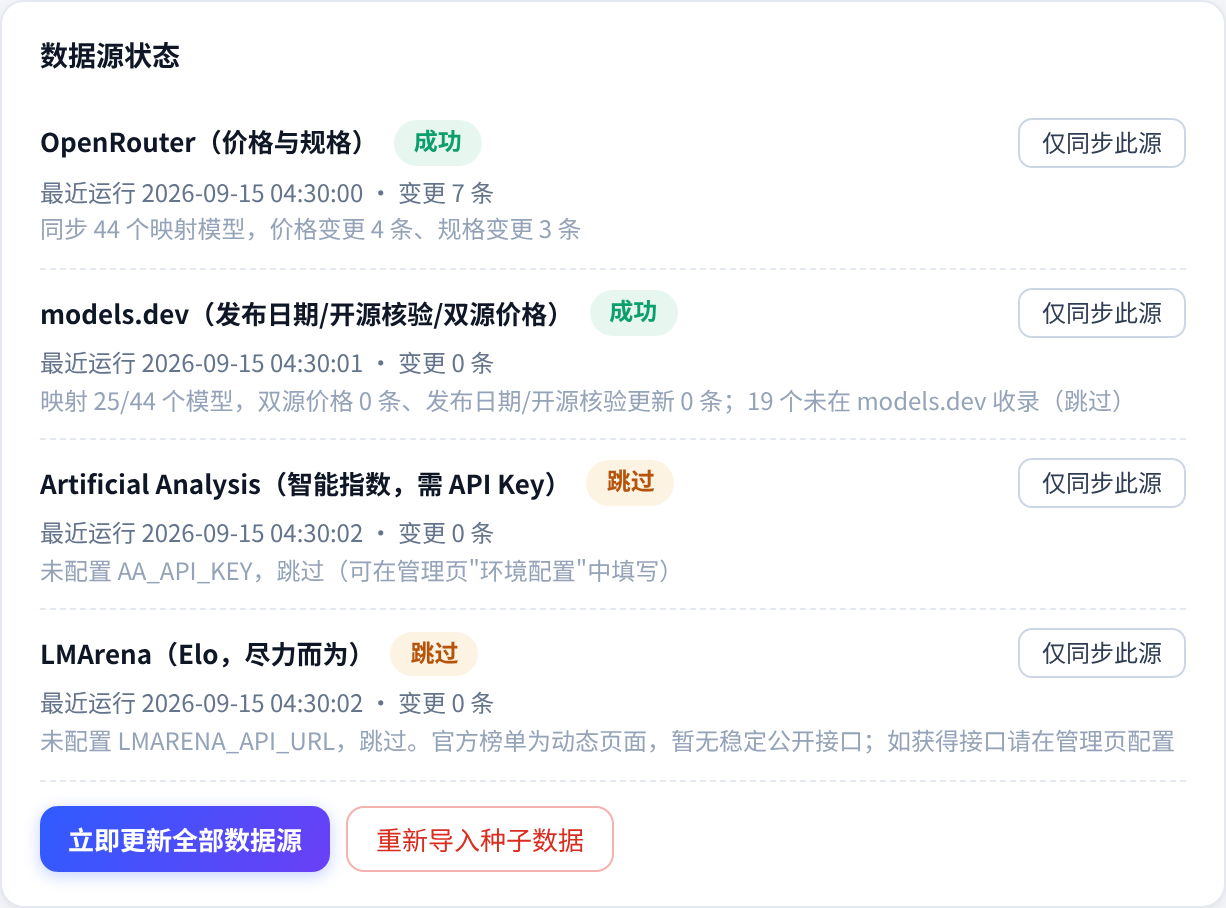
第一,每天凌晨四点半自动巡逻。它自己去几个数据源转一圈:谁涨价了、谁降价了、谁把开源权重放出来了,默默记下来。哪个数据源当天闹脾气抓取失败,它就把失败原因写进日志,其他数据源照常工作,互不拖累。
第二,双份账本互相印证。价格这类关键数据,它从两个独立渠道各记一份,并排展示。上线后这份"双保险"立刻立了功:一边报一个价、另一边报另一个价,差异一目了然,谁也别想糊弄谁。它还顺着新渠道核出过一个我当初标错的数据——某个模型明明是闭源的,却被我标成了"开放权重",被自动核对的数据当场抓了出来。
第三,新模型雷达。数据源里冒出一个没见过的新型号,它就记到候选清单上。我打开管理后台,就能看到这样一张名单——连"即将出生"的模型都在监视范围里。看对了眼,点一下"收录",新模型的档案自动建好,规格和价格立刻入库。
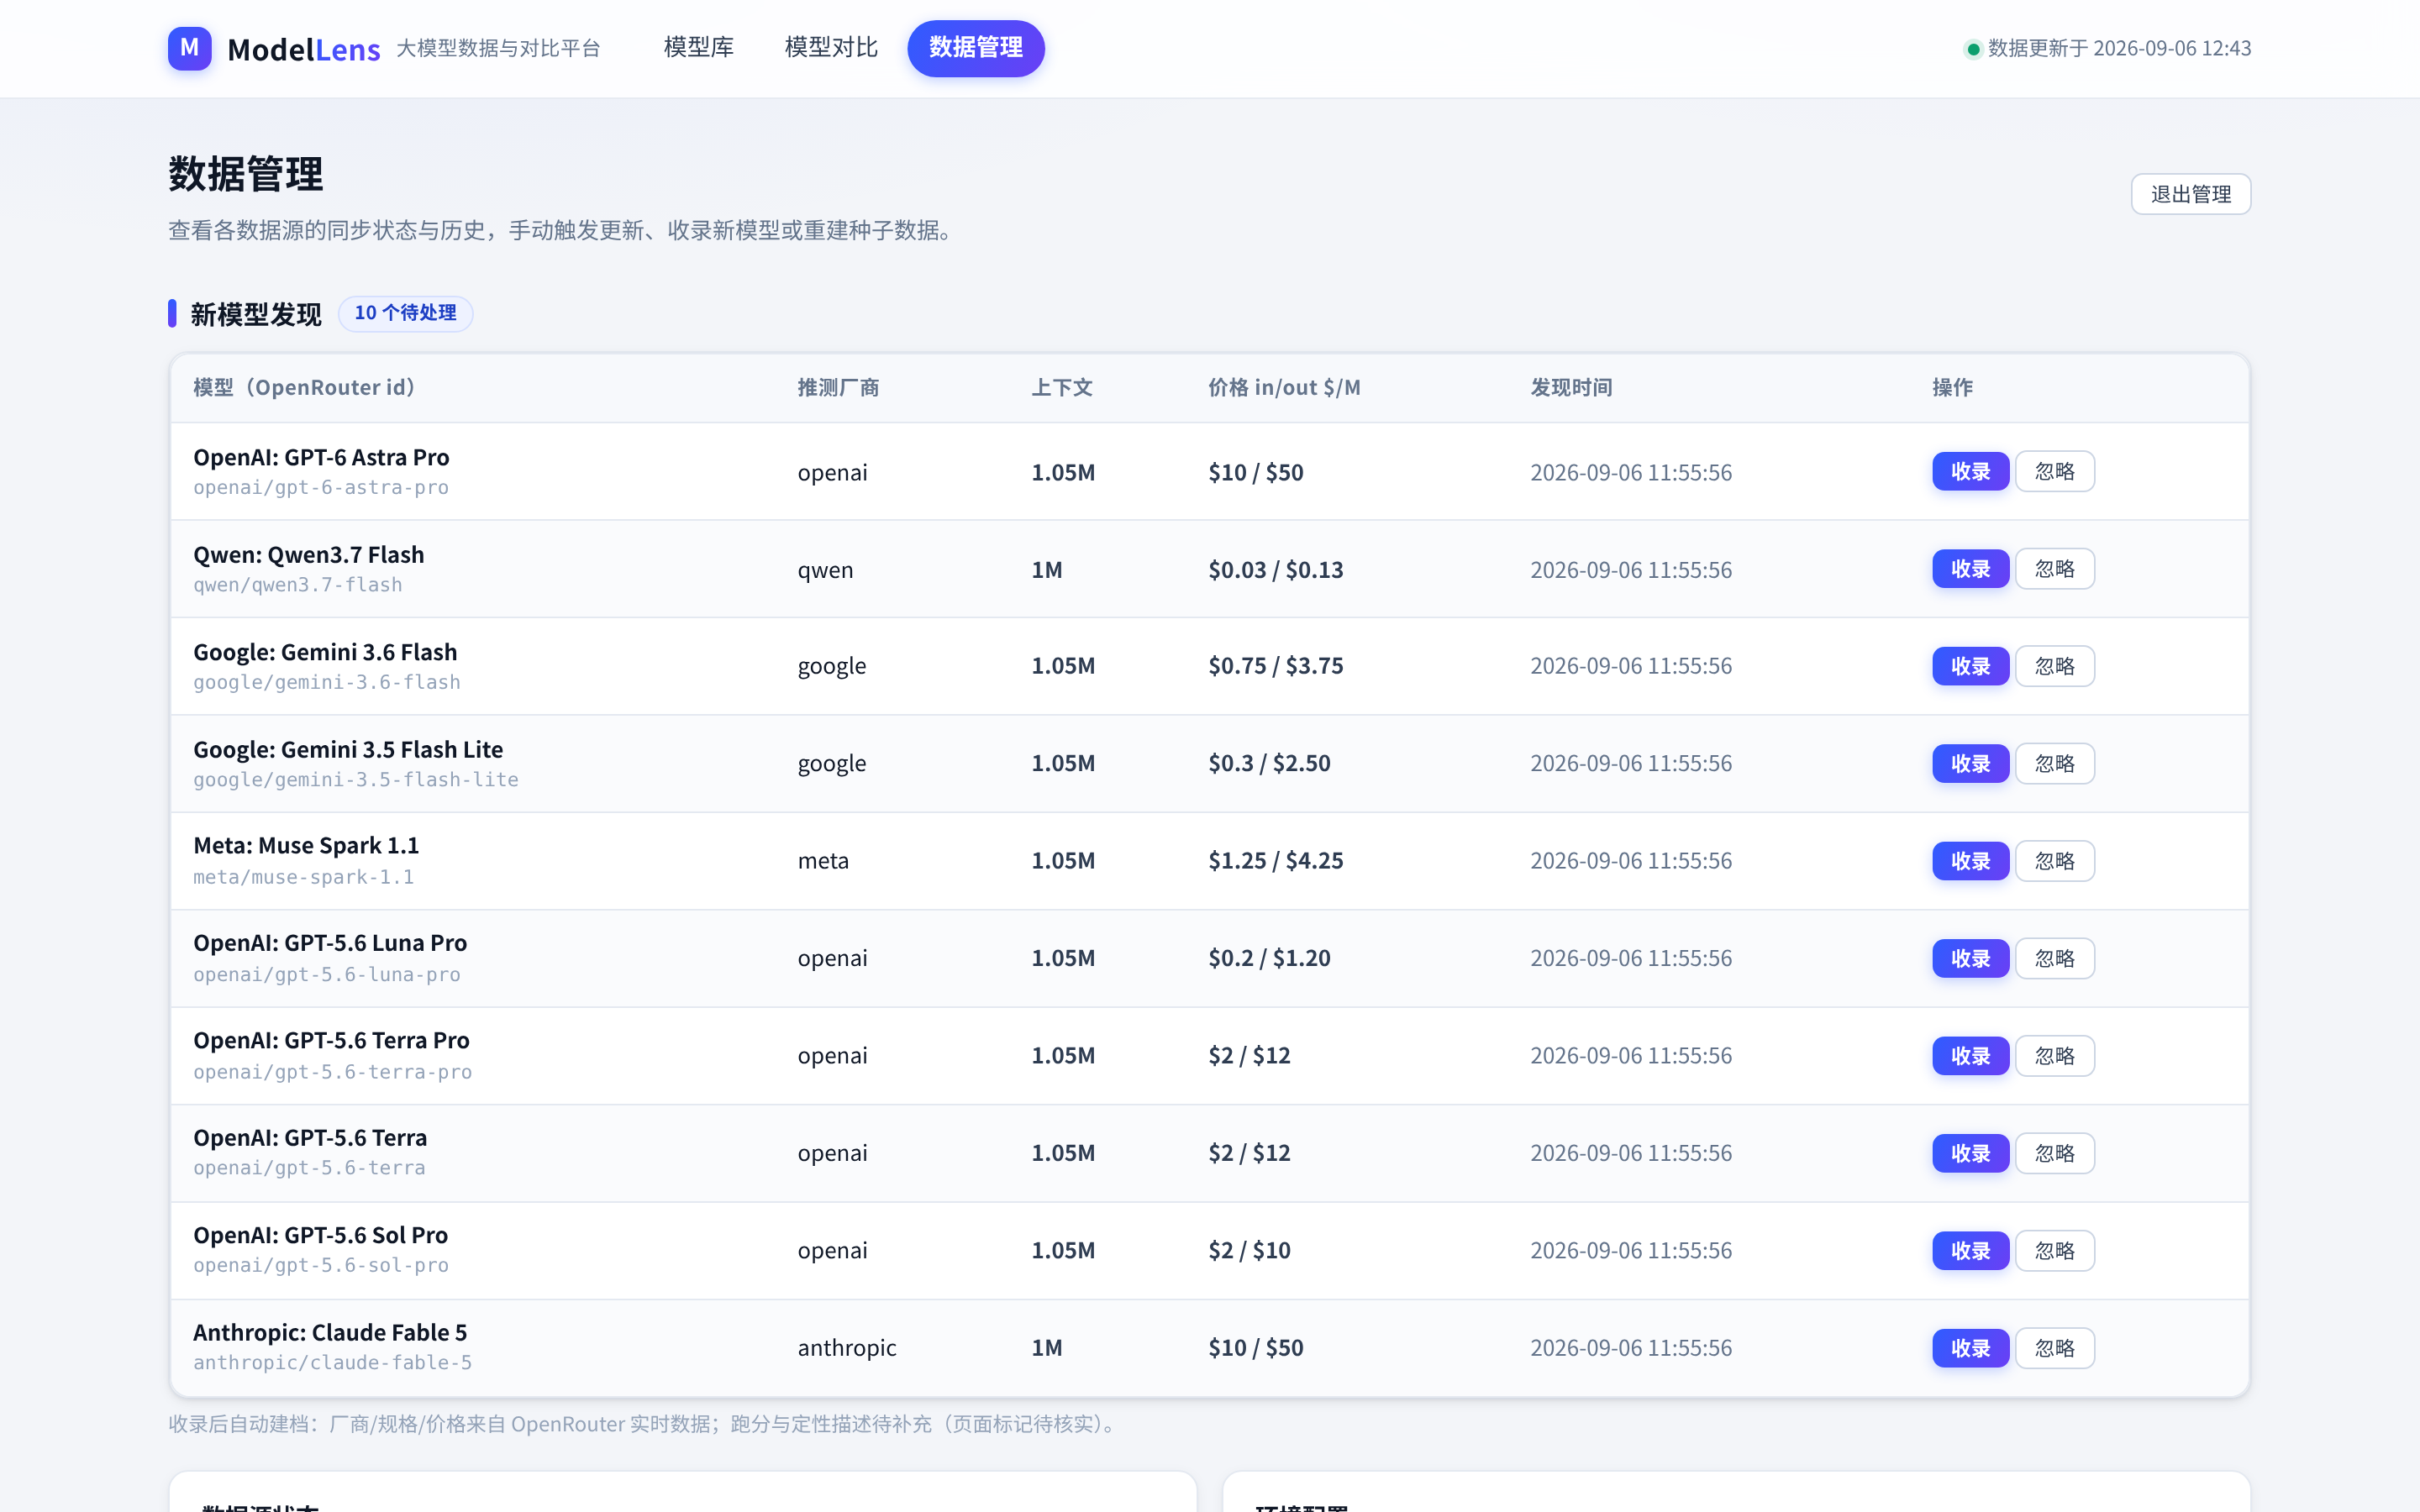
后台的抓取频率、各种密钥,也都能在这个界面里直接改,保存即生效,不用跑去服务器上折腾。这样就算哪天我在外面用手机,发现抓取频率想调整,也是一分钟能搞定的事。
数据的"为人处世"
如果把这个网站当作一个人,我希望它的性格是这样的:
较真。每个数字必须有出处。同一个指标两家来源打架?都留着,都标注,让读者自己看,绝不偷偷平均抹平。
谦逊。查不到就写"待核实"。首页上你确实会看到几个"待核实",那不是没做完,是我不愿意编。
有分寸。它只在自己的一亩三分地里活动,不碰服务器上的邻居;管理后台锁着门,写操作全部在密码之后。
勤快而不越界。该自动的(价格、规格、新模型嗅探)全自动;不该自动的(跑分核验、能力评价)老实人工整理——因为评测口径的水太深,自动化抓来的数字如果不加分辨,看着整齐,错得离谱。
写在最后
从一个"到处问模型哪个强"的烦恼出发,到每天自动更新、手机能用的正式站点,这段折腾的日子值了。
回头看看,做这个小项目教会我的,其实和写代码关系不大:是较真的价值——一个下划线的疏忽就能让十四个名字消失;是敬畏的分寸——一次图省事的命令能放倒一片服务;也是诚实的底气——敢写"待核实",才有资格让读者相信其他每一个数字。
模型的世界每天都很热闹。而它会在热闹旁边,安安静静地,记一笔一笔的账。
网站地址:https://model.heylai.cyou
记于 2026 年 9 月。
附:技术栈速览(给同行朋友)
- 后端 Node.js + Express + SQLite,前端 React + Vite + ECharts,nginx 反代 + systemd 常驻 + certbot 自动续期
- 数据源:OpenRouter、models.dev 双渠道每日自动抓取;跑分以人工核验的种子数据为主(来源:Artificial Analysis、Vals AI、Epoch AI 等,逐条标注口径)
- 想折腾类似项目的,部署手册、开发手册、自动抓取手册我都有整理,欢迎交流
评论
抢个沙发还没有评论,来说点什么吧。